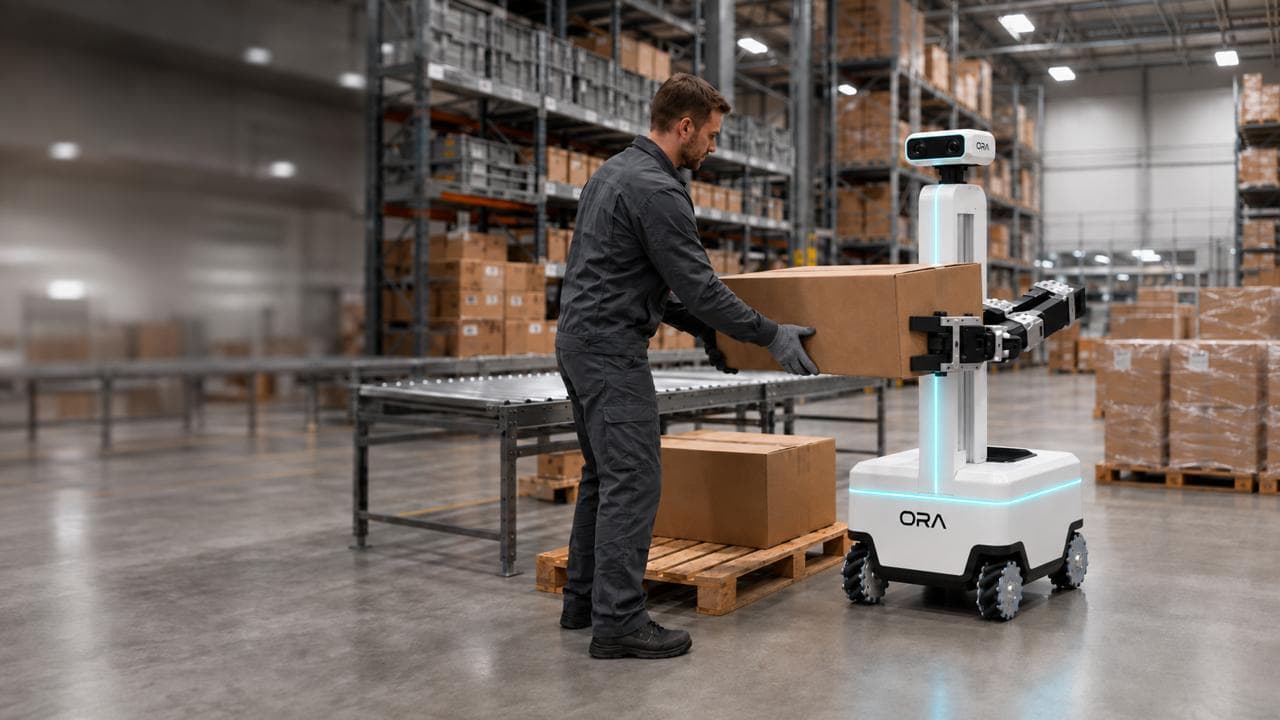
Un robot qui ne voit pas ne peut pas agir.
Layer Vision est la couche de perception de notre robot. Elle transforme des flux caméra bruts en compréhension de la scène, en temps réel, en embarqué, et elle est construite sur une décennie de vision par ordinateur en production chez XXII.
Chaque geste commence par un regard.
Un bras robotique peut être précis au dixième de millimètre et rester inutile. Sans perception, il ne sait pas où est la boîte, que la boîte a bougé, qu'une personne vient d'entrer dans sa trajectoire, ou que la pièce devant lui n'est pas la bonne.
La manipulation est une boucle fermée : voir, décider, bouger, revoir. La qualité de cette boucle dépend de la qualité de la vision. C'est pourquoi nous n'avons pas acheté notre perception, nous l'avons construite.
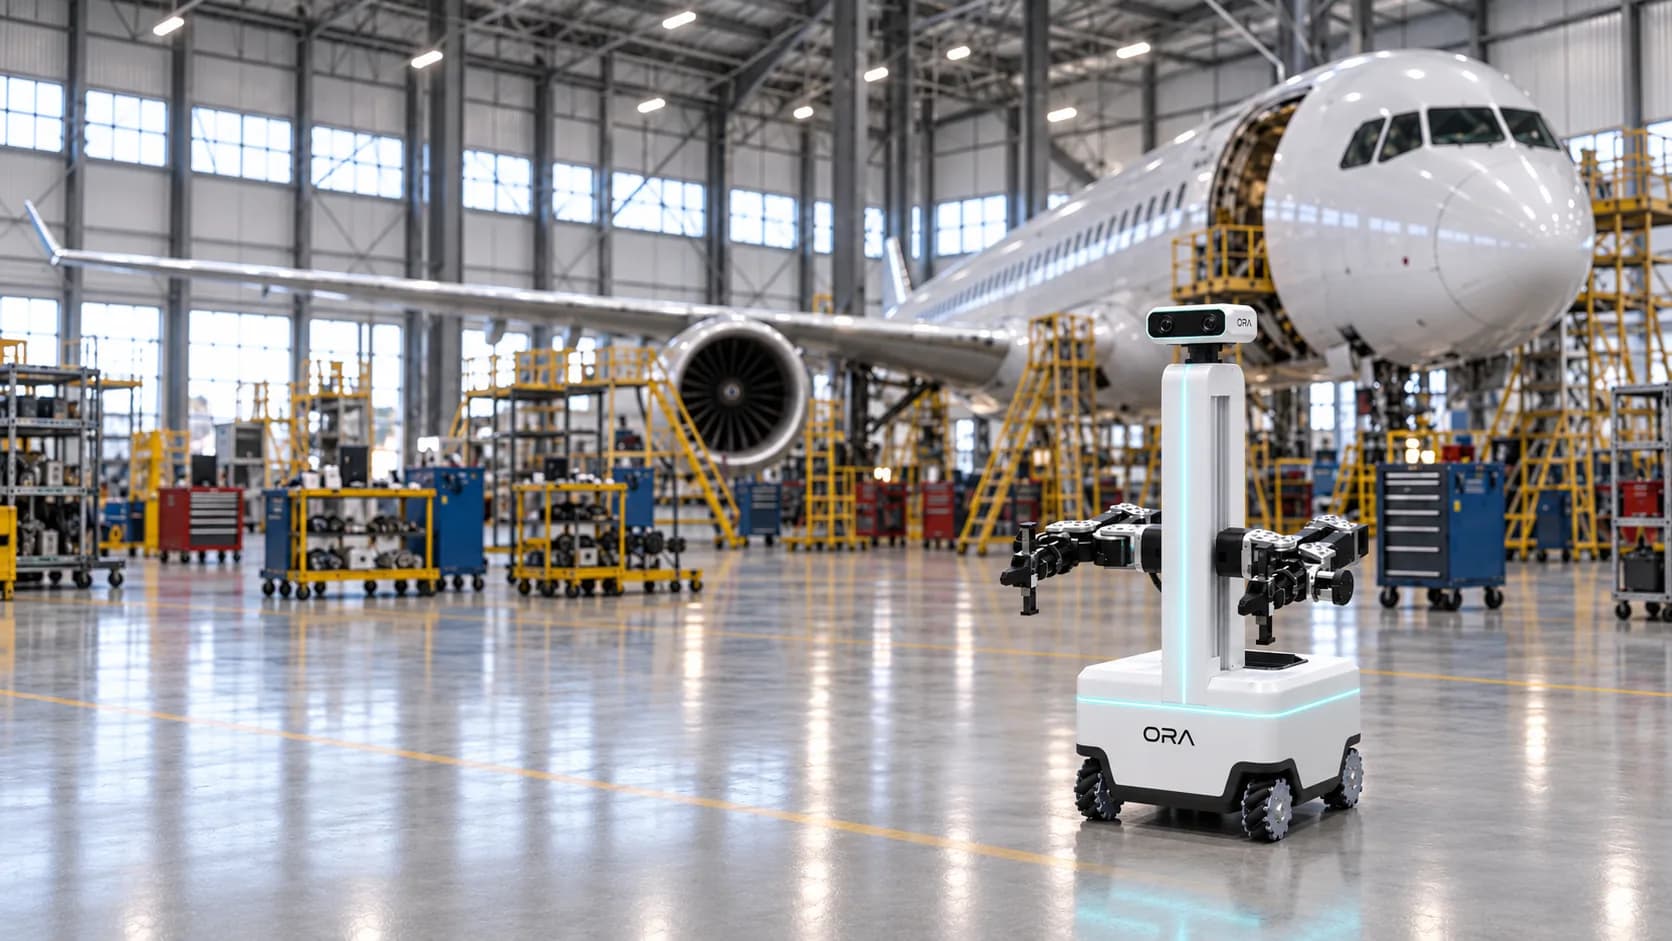
Des pixels à une scène exploitable.
Quatre couches tournent sur chaque image, de l'entrée capteur brute à la description structurée consommée par la politique de contrôle.
Détection
Personnes, véhicules, conteneurs, outils, pièces. Quels objets sont dans le cadre, où, et avec quel niveau de confiance le modèle évalue chacun.
Suivi
L'identité est conservée d'une image à l'autre, si bien qu'une boîte qui bouge reste la même boîte et une personne qui passe est une seule personne, pas trente détections.
Pose spatiale
Où se trouvent les choses en trois dimensions par rapport au robot, et comment elles sont orientées — ce qui transforme une détection en quelque chose de saisissable.
Compréhension de la scène
Les relations qui comptent : ce qui est posé sur quoi, ce qui bloque le passage, ce qui est mal placé, ce qui a changé depuis le dernier passage.
S'il faut passer par le cloud, c'est trop lent.
Une main qui se referme sur un objet en mouvement n'a pas le temps d'un aller-retour vers un data center. La perception tourne sur le robot, sur du calcul embarqué, dans un budget de latence fixe.
Inférence embarquée
La chaîne complète tourne sur le calcul embarqué du robot. Aucune dépendance au cloud, aucun coût de bande passante, aucun risque de panne.
Budget de latence fixe
La perception est conçue autour de la boucle de contrôle, pas l'inverse. Un temps de réponse prévisible est une exigence de sécurité.
Dégradation progressive
Faible luminosité, flou de mouvement, occlusion partielle. Le moteur signale l'incertitude plutôt que de deviner, et le robot ralentit.
Indépendant du capteur
Caméras aux poignets, tête 360°, profondeur. Layer Vision fusionne les flux plutôt que de dépendre d'un seul capteur parfait.
Pas un prototype de recherche. Une décennie en production chez XXII.
Layer Vision n'a pas commencé avec le robot. Elle a commencé des années plus tôt chez XXII, en analysant de la vidéo en direct dans des environnements industriels et urbains, où un faux positif coûte de l'argent réel à quelqu'un et une détection manquée coûte plus encore. La robotique hérite d'un moteur déjà endurci par le terrain.
Vision par ordinateur en production
Construite et déployée bien avant l'existence du robot, sur des flux vidéo réels en conditions d'exploitation réelles.
Endurcie par le déploiement
Ajustée contre les défaillances qui n'apparaissent que sur site : reflets, poussière, affluence, caméras que personne ne nettoie.
La nôtre, de bout en bout
Modèles, pipeline et runtime embarqué nous appartiennent, ce qui nous permet de les changer le jour où le terrain le demande.
Un robot travaille parmi des personnes. Il ne les surveille pas.
Détecter une personne pour ralentir et céder le passage est une fonction de sécurité, pas une identification. Notre perception est conçue pour que les deux ne soient jamais confondues, et pour qu'un exploitant de site puisse le prouver.
La perception rend une instruction en langage naturel exécutable.
Les modèles Vision Language Action ont besoin d'ancrer le langage dans quelque chose. Quand un opérateur dit « prends le bac gris sur la deuxième étagère », c'est Layer Vision qui décide quels pixels sont le bac gris, où il se trouve dans l'espace, et si la pince peut l'atteindre. Même boucle en sens inverse pendant la capture : ce que la couche de perception voit est ce que le dataset enregistre.
Donnez à vos robots des yeux conçus pour le terrain.
Parlez-nous de votre environnement, de vos capteurs et de vos contraintes de latence. Nous vous dirons ce que notre couche de perception peut y faire.